האם האתר שלכם מוכן לסוכני AI? בדקנו 22 חברות סייבר
מה בדקנו ומה מצאנו?
בדקנו את האתרים של 22 חברות סייבר B2B, והצלחנו להשלים מדידה מלאה של 14 מהם.
רק 5 מתוך ה-14 עברו את כל הבדיקות הקריטיות בשלושת שלבי המוכנות הראשונים: נגישות, מציאת תוכן וקריאות עבור סוכני AI. אצל השאר נמצאו בעיות טכניות שעלולות להקשות על סוכנים לגלות את המידע, לקרוא אותו או להבין את ההקשר שלו.
חשוב לומר מה זה לא אומר. המחקר מודד מוכנות טכנית לפי מודל בדיקה, לא את מה שסוכן מסוים עשה בפועל באתר, ולא נראות בתשובות AI. אלה שלושה דברים שונים, ונחזור להבחנה הזו לאורך המאמר.
וגילוי נאות: אחת מחמש החברות שעברו היא Red Button, לקוחה של Alt_, שהגיעה לשלב הזה אחרי עבודה שעשינו יחד.
הממצא המעניין יותר הוא איפה החברות נכשלות. לא בטקטיקות GEO חדשות כמו llms.txt או MCP, אלא בפרקטיקות בסיסיות שכל איש SEO מכיר: sitemap שבור, כתובת שלא קיימת שמחזירה 200, ו-Organization schema חסר או שבור.
איך המחקר התחיל?
כשהתחלנו לעבוד עם Red Button, חברת הגנת DDoS שפועלת בישראל, באירופה ובארה״ב, רצינו להבין איפה האתר שלה עומד מול המתחרים. החל מאוקטובר 2026 עקבנו אחרי האתרים של 22 חברות סייבר B2B, מחברות בוטיק ועד שמות גדולים בתחום. את 14 מהן הצלחנו למדוד במלואן. אצל 8 הנוספות כלי המדידה לא קיבל תשובה ברורה.
מה ההבדל בין גוגל לסוכן AI?
גוגל סורק את האתר לאורך זמן, מריץ JavaScript ובונה אינדקס. סורק של מנוע AI ניגש לאתר בדרך כלל כדי לשלוף תוכן לתשובה, ורבים מהם לא מריצים JavaScript בכלל. לפי מחקר של Vercel מדצמבר 2024, הסורקים המרכזיים של OpenAI, Anthropic, Meta ו-Perplexity לא הריצו JavaScript. היוצאים מן הכלל באותו מחקר היו Gemini, שמשתמש בתשתית של Googlebot, ו-AppleBot, ששניהם מרנדרים דפים.
וכאן צריך להבחין בין סורקים לבין סוכנים. סוכן שמפעיל דפדפן מלא יכול לראות תוכן שנטען ב-JavaScript. Anthropic, למשל, מתעדת בנפרד את הדפדפנים שבהם Claude משתמש כדי לבצע משימות, תחת הזיהוי Claude-Agent. אבל אי אפשר להניח שכל מערכת AI תעשה זאת. תוכן שמתווסף רק בדפדפן עלול להיעלם בדיוק עבור הסורקים ששולפים מידע לתשובות, והם לא יודיעו לכם שמשהו חסר.
מהם ארבעת שלבי המוכנות לסוכני AI?
המודל שלנו מבוסס על בדיקת Agent Readiness של Peec AI, שמדרגת אתרים בחמש רמות. אנחנו מאחדים את שתי הרמות העליונות לשלב אחד, כי לאף אחת מהן עדיין אין בדיקות שמשפיעות על הציון. השלבים מצטברים: אתר עומד בשלב רק אם הוא עובר את כל הבדיקות הקריטיות של אותו שלב ושל כל השלבים שלפניו. אתר שנכשל כבר בשלב הראשון מסומן אצלנו בשלב 0.
| שלב | השאלה | הבדיקות הקריטיות |
| 1. נגיש | סוכנים יכולים להיכנס לאתר? | robots.txt תקין, וסורקי חיפוש וסוכנים שפועלים בשם משתמש לא חסומים בו |
| 2. ניתן למציאה | סוכנים יכולים למצוא את התוכן? | sitemap מוצהר ותקין, אין noindex, כתובת שלא קיימת מחזירה 404, ניווט שעובד בלי JavaScript |
| 3. קריא | סוכנים יכולים לקרוא ולחלץ מידע? | תוכן שמופיע בלי JavaScript, JSON-LD תקין, זהות ארגונית ב-schema, תוכן מרכזי בתוך main או article |
| 4. מאפשר פעולה | סוכנים יכולים לפעול באתר? | אין עדיין בדיקות שמשפיעות על הציון. נבדקים סימנים כמו API catalog, MCP, OAuth discovery, ובאיקומרס UCP |
שלב 1, נגיש
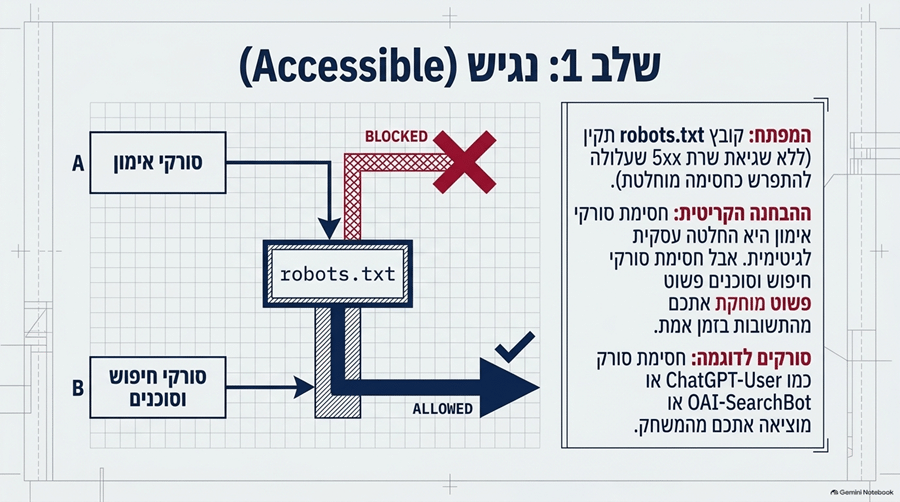
סורקים מסודרים קוראים את robots.txt ראשון. לפי התיעוד של Peec, שגיאת שרת (5xx) על הקובץ גרועה יותר מקובץ חסר, כי סורק עלול לפרש אותה כחסימה של כל האתר. וחשוב להבחין בין סורקי אימון של מודלים לבין סורקי חיפוש וסוכנים שפועלים בשם משתמש. חסימת סורקי אימון היא החלטה עסקית לגיטימית, והיא לא מוציאה אתכם מתשובות. חסימה של סורקי חיפוש עלולה כן.
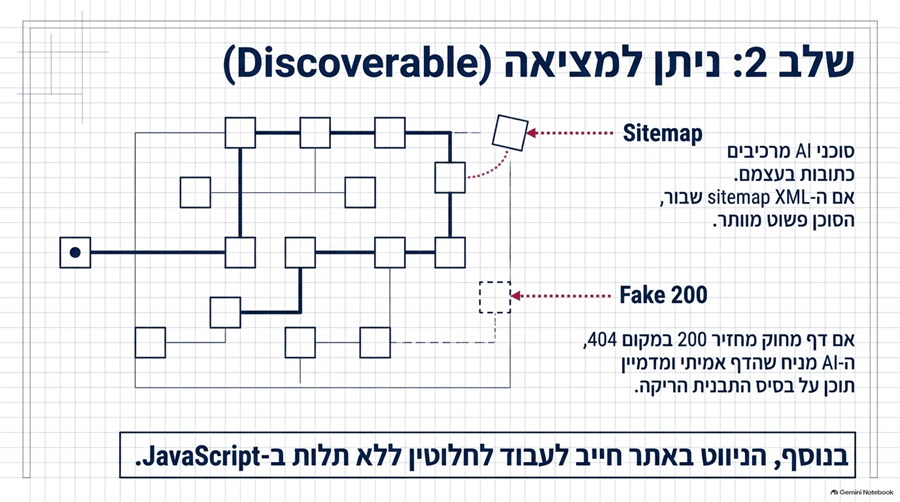
שלב 2, ניתן למציאה
סוכנים לא רק עוקבים אחרי קישורים, הם גם מרכיבים כתובות בעצמם. אם כתובת שלא קיימת מחזירה 200 או מפנה לדף הבית, הסוכן עלול להניח שהדף קיים ולהשתמש במה שקיבל כאילו זה התוכן שלו. גם הניווט נבדק כאן: Peec דורשת לפחות 80% חפיפה בין הקישורים ב-HTML שהשרת מחזיר לבין הקישורים אחרי רינדור. זה סף שהכלי הגדיר, לא תקן אוניברסלי.
ה-sitemap הוא כלי עזר לגילוי ולא תנאי הכרחי. לפי Google, סורקים מוצאים דפים גם דרך קישורים פנימיים וחיצוניים, ו-sitemap עוזר בעיקר לדפים שקשה להגיע אליהם. במודל של Peec הוא בדיקה קריטית, גם משום שהכלי בוחר ממנו את הדפים לבדיקה.
שלב 3, קריא
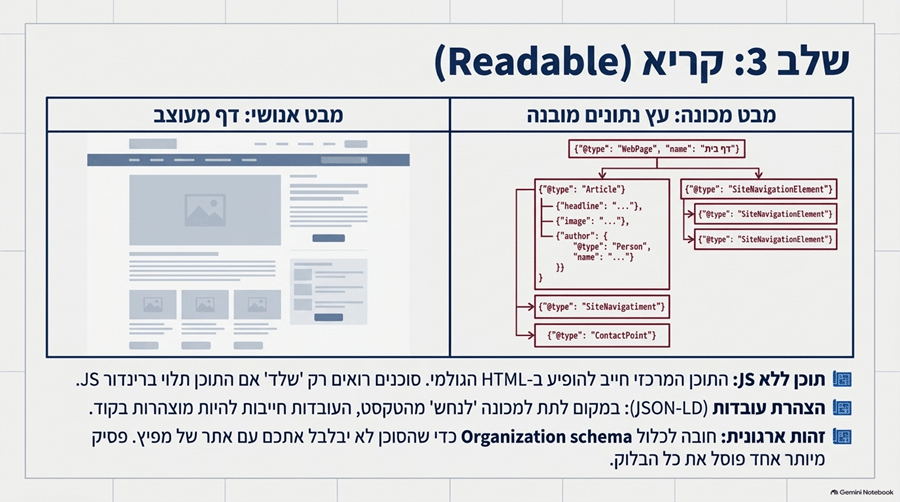
כאן נבדק אם התוכן עצמו נגיש. Peec משווה את המילים ב-HTML הגולמי לדף אחרי רינדור, ושוב דורשת 80% חפיפה. JSON-LD הוא המקום שבו העובדות שלכם כתובות במפורש, במקום שהסוכן יסיק אותן מהטקסט. פסיק מיותר אחד פוסל בלוק שלם, והדף ממשיך להיראות תקין, כך שאף אחד לא שם לב. ובדיקה שלא תמיד חושבים עליה: האם התוכן המרכזי יושב בתוך תגית main או article, כדי שסוכן שמקבל את כל הדף ידע איפה התוכן מתחיל.
שלב 4, מאפשר פעולה
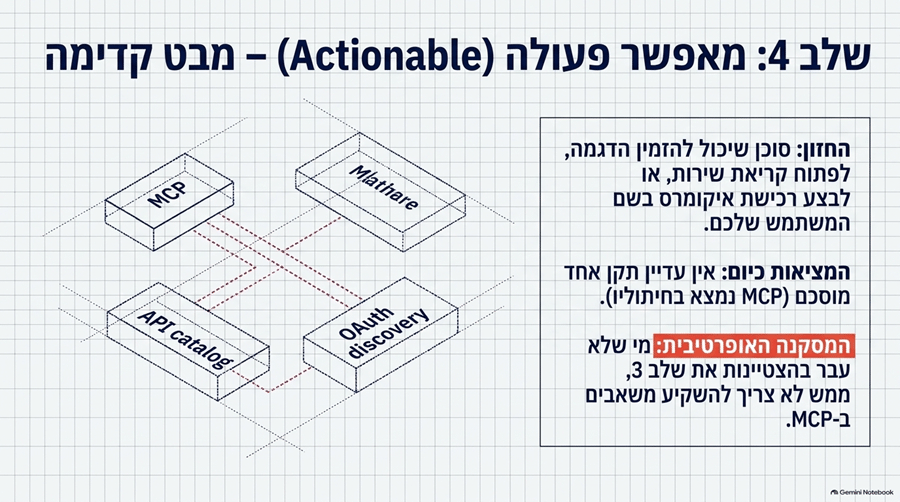
זה סוכן שמזמין הדגמה, פותח קריאת שירות או קונה בשם המשתמש. יש כבר פרוטוקולים ופתרונות, בהם MCP, A2A, API catalog ו-UCP, אבל עדיין לא התגבש פתרון אחיד לכל סוגי הפעולות, ו-Peec לא סופרת את הבדיקות האלה בציון. לכן שלב 3 הוא כרגע השלב הגבוה ביותר שאתר יכול לקבל במודל, ואנחנו מתייחסים לשלב 4 כמבט קדימה ולא כדרישה. וכדאי לזכור שסוכן שמפעיל דפדפן יכול למלא טופס או ללחוץ על כפתור גם בלי אף אחד מהפרוטוקולים האלה.
איפה חברות הסייבר נתקעות?
כמעט כולן נגישות, אבל חצי מהן נעצרות כבר בשלב השני.
| שלב | חברות שעברו (מתוך 14) |
| 1. נגיש | 13 |
| 2. ניתן למציאה | 7 |
| 3. קריא | 5 |
ואלה הבדיקות שהפילו את החברות. חלק מהחברות נכשלו ביותר מבדיקה אחת:
| הבדיקה | שלב | חברות שנכשלו (מתוך 14) |
| JSON-LD וזהות ארגונית חסרים או שבורים | 3 | 6 |
| כתובת שלא קיימת מחזירה 200 במקום 404 | 2 | 3 |
| sitemap לא תקין | 2 | 2 |
| noindex על דף שצריך להופיע בתשובות | 2 | 1 |
| robots.txt בפורמט לא תקין | 1 | 1 |
| תוכן וניווט שתלויים ב-JavaScript | 2 ו-3 | 1 |
ה-schema הוא החסם הנפוץ ביותר במודל הבדיקה. אצל 6 חברות אין בלוק JSON-LD שמצהיר מי החברה, או שהבלוק שבור. זה לא אומר שסוכן לא יבין מי הן. טקסט ברור יכול לספק את המידע הזה גם בלי schema. נתונים מובנים מצמצמים עמימות ועוזרים להבדיל בין האתר הרשמי לבין מפיץ או אתר שרק מזכיר את החברה, אבל המחקר הזה לא מוכיח שהיעדרם פגע בהבנה של האתר או בציטוט שלו.
שלוש חברות היו במרחק תיקון אחד ממוכנות מלאה לקריאה
שלוש חברות עוברות את כל הבדיקות של שלב 3, ובכל זאת עומדות בשלב 1. כל אחת מהן נכשלה בבדיקה אחת בלבד של שלב 2: אצל אחת זה דף עם noindex, אצל השנייה sitemap שבור, ואצל השלישית כתובת שלא קיימת שמחזירה 200. תיקון נקודתי אחד יקפיץ כל אחת מהן שני שלבים במודל. לפעמים הבעיה לא דורשת אסטרטגיה חדשה, אלא טיפול בחסם טכני אחד שאף אחד לא שם לב אליו.
וגם שלב 3 לא מבטיח הכול. בנוסף לבקשות הרגילות, Peec שולחת לדף הבית בקשות שמזדהות כ-GPTBot, OAI-SearchBot, ClaudeBot ו-PerplexityBot, מכתובות ה-IP של Peec עצמה. שתיים מהחברות שהגיעו לשלב 3 החזירו שגיאה לבקשות האלה. ייתכן שהן חוסמות בוטים מתחזים ומאפשרות לאמיתיים, וייתכן שלא. את זה בודקים בלוגים של השרת, לא מבחוץ.
פרדוקס חברות הסייבר: איך מאפשרים גישה לסוכני AI בלי להחליש את ההגנה מבוטים?
את 8 החברות הנוספות לא הצלחנו למדוד, וביניהן חלק מהשמות הגדולים בתחום. אצלן הבדיקה נחסמה, הבקשה נכשלה לפני שהושלמה, או ש-robots.txt היה גדול מדי לקריאה. זה 8 מתוך 22, יותר משליש מהמדגם, ולכן אי אפשר להשליך את תוצאות 14 האתרים על כולן. ייתכן שהאתרים שלא נמדדו שונים מהשאר באופן שיטתי, למשל ברמת ההגנה שלהם.
זה גם לא אומר שהן חוסמות סוכני AI. כלי מדידה פונה משרתים של חוות שרתים, ומערכות הגנה מבוטים יודעות לזהות בקשות שרק מתחזות לבוט מוכר. הסורקים האמיתיים של OpenAI, Anthropic ו-Perplexity פונים מטווחי IP מוצהרים, וייתכן מאוד שהם עוברים. בדקנו גם בעצמנו וקיבלנו תשובות לא עקביות: אתר אחד חסם בקשה שמזדהה כדפדפן, והחזיר תשובה תקינה לבקשה שמזדהה כ-ClaudeBot.
אז למה זה בכל זאת מעניין? כי סוכנים הם לא רק הסורקים המוכרים. כלי מחקר, דפדפני AI וסוכנים שחברות בונות לעצמן לא תמיד מגיעים מטווח מוצהר. אתר שמוגן היטב מדי עלול להיות אטום גם למי שהוא כן רוצה שיקרא אותו. לחברת סייבר זה איזון מובן, ולפעמים נכון. אבל צריך לקבל אותו במודע, ולבדוק בלוגים מי בפועל נכנס ומי נחסם.
קייס סטאדי: איך Red Button עלתה משלב 1 לשלב 3
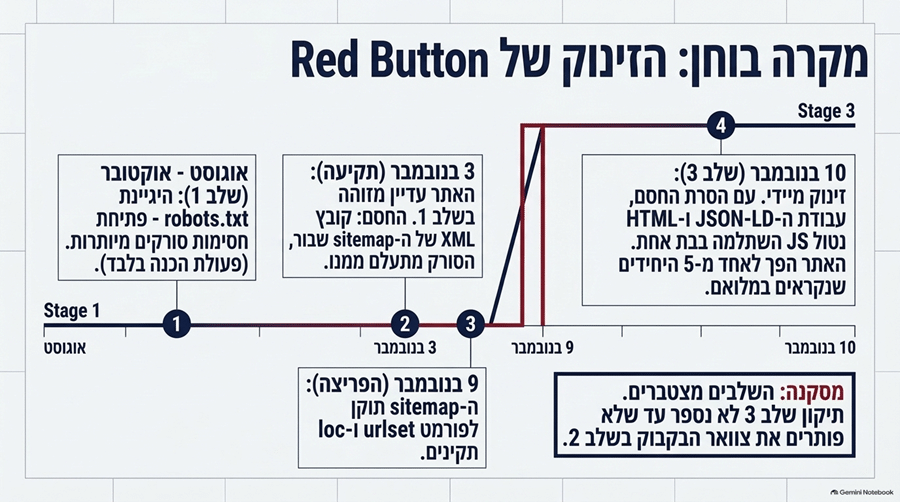
המחקר התחיל מהאתר של Red Button. עד תחילת נובמבר האתר עמד בשלב 1. יום אחרי התיקון האחרון הוא כבר היה בשלב 3, אחד מחמשת האתרים במדגם שהגיעו לשם. חשוב לדייק מה זה אומר: האתר התקדם במדד המוכנות הטכנית. במחקר הזה אין נתונים על שינוי בביקורי סורקים, באזכורים או בציטוטים בתשובות AI, ועדיין מוקדם מדי למדוד אותם.
פעולה 1: בחינת החסימות ב-robots.txt
שישה סורקים היו חסומים לכל האתר עם Disallow: /, ביניהם Amazonbot, Meta-ExternalAgent ו-Diffbot. עברנו על כל חסימה ובחנו את הצורך העסקי בה, ואחרי הבדיקה הוחלט לאפשר להם גישה. וכאן חשוב להיות מדויקים: זה לא מה שהזיז את השלב. הסורקים שקובעים אם אתר עובר את שלב 1 הם סורקי החיפוש והסוכנים שפועלים בשם משתמש, והם לא היו חסומים. הפעולה התאימה את מדיניות הסריקה לצורכי החשיפה של החברה. הסורקים האלה לא שקולים זה לזה ולא לסורקי החיפוש של ChatGPT או Claude, ולכן ההמלצה היא לא לפתוח הכול, אלא להחליט על כל אחד במודע.
פעולה 2: תיקון ה-sitemap
זה היה החסם במודל. ה-sitemap נטען, אבל לא היה קובץ sitemap תקין, וסורק שלא מצליח לפענח אותו מתעלם ממנו. תיקנו את מבנה ה-XML כך שכל קובץ הוא urlset או sitemapindex תקין, עם loc לכל רשומה. שישה ימים אחרי שהבעיה זוהתה היא תוקנה, ולמחרת האתר עלה שני שלבים.
פעולה 3: תוכן שמוצג בלי JavaScript
דאגנו שהתוכן המרכזי של כל תבנית מגיע כבר ב-HTML שהשרת מחזיר, ולא נטען רק אחרי ש-JavaScript רץ. בלי זה, סורק שלא מריץ JavaScript רואה שלד של דף, בלי התוכן שעונה על השאלה.
פעולה 4: זהות ארגונית ב-schema
הוספנו JSON-LD מסוג Organization עם שם, כתובת קנונית ו-sameAs לפרופילים הרשמיים, ו-@id שדפים אחרים מפנים אליו. כך האתר מצהיר במפורש שהוא האתר הרשמי של החברה, ולא מפיץ או אתר שרק מזכיר אותה.
פעולה 5: schema לסוג הדף
בדפי התוכן (קייסים, מילון, דוחות) היה JSON-LD תקין, אבל בלי סוג דף מוצהר. סוכן שקורא את הדף רואה עובדות, אבל לא יודע שמדובר במאמר עם כותב ותאריך. הוספנו Article לתבניות התוכן. זה לא משנה את השלב, כי במודל של Peec זו בדיקה משנית, אבל זה מה שהופך אתר שעובר בדיקה לאתר שקל להבין.
מה למדנו?
השלבים מצטברים, ולכן הסדר חשוב. העבודה על התוכן ועל ה-schema לא הופיעה בציון כל עוד בדיקה בשלב 2 נכשלה. ברגע שה-sitemap תוקן, האתר עלה בבת אחת שני שלבים. זה נכון לגבי המודל. האם זה ישפיע על הנראות של Red Button בתשובות AI, נדע רק כשנמדוד את זה בנפרד.
איך בודקים את האתר שלכם?
רוב הבדיקות הקריטיות לא דורשות כלי בתשלום. חלק מהן אפשר לעשות לבד בדפדפן בכמה דקות, וחלק דורשות מפתח או גישה ללוגים.
בדיקות שאפשר לעשות לבד
שלב 1, נגיש
- פתחו את /robots.txt. אתם אמורים לראות טקסט פשוט עם User-agent, לא דף HTML ולא שגיאה.
- חפשו בקובץ את OAI-SearchBot, Claude-SearchBot ו-PerplexityBot. אם מופיע אצלם Disallow: /, המנוע הזה לא יוכל לשלוף את הדפים שלכם לתשובות החיפוש שלו. הוא עדיין יכול להזכיר אתכם ממקורות אחרים.
שלב 2, ניתן למציאה
- בדקו שיש שורת Sitemap: ב-robots.txt, ושה-sitemap נפתח כ-XML תקין. ב-Search Console תראו את זה תחת Sitemaps.
- הקלידו כתובת שלא קיימת, למשל /xyz-test-404. אתם צריכים לקבל דף שגיאה, לא את דף הבית.
- חפשו noindex ב-View Source של דפי השירות והתוכן המרכזיים.
- כבו JavaScript בדפדפן וטענו מחדש. התפריט הראשי צריך להישאר עם קישורים שעובדים.
שלב 3, קריא
- עם JavaScript כבוי, בדקו שהתוכן המרכזי עדיין שם. מחירים, מפרטים ו-FAQ נעלמים ראשונים.
- הריצו את דף הבית ב-Schema Markup Validator. אפס שגיאות, וצומת Organization עם שם ו-URL.
- ודאו שלצומת Organization יש sameAs שמקשר ללינקדאין ולפרופילים הרשמיים שלכם.
בדיקות שדורשות מפתח
- בדקו את קוד הסטטוס של כתובת שלא קיימת בבקשת GET, לא רק בבקשת HEAD (curl -I). יש שרתים שמחזירים תשובות שונות לשתיהן, והתשובה הנכונה היא 404 או 410.
- בדקו בלוגים של השרת או של ה-CDN אם סורקי החיפוש והסוכנים, בהם OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User ו-PerplexityBot, מקבלים 200 או 403. ה-firewall יכול לחסום גם כש-robots.txt פתוח. אמתו שהבקשות מגיעות מטווחי ה-IP שהחברות מפרסמות, כדי להבדיל בין סורק אמיתי למתחזה.
- שימו לב ש-ChatGPT-User פועל ביוזמת משתמש, ו-לפי OpenAI כללי robots.txt לא בהכרח חלים עליו. מה שקובע אם תופיעו בתשובות החיפוש של ChatGPT הוא OAI-SearchBot.
- ודאו שהתוכן המרכזי בכל תבנית עטוף בתגית main או article.
עברתם את כל הרשימה? אתם כנראה בשלב 3. השלב הבא הוא לא עוד בדיקה טכנית, אלא מה שכתוב בדפים: האם התוכן עוזר ללקוח לקבל החלטה. כתבנו על זה במדריך אופטימיזציה לסוכני AI, ועל המבנה שהופך תוכן לניתן לציטוט במדריך כתיבה לציטוט במנועי AI.
רוצים לדעת איפה האתר שלכם עומד?
אנחנו בודקים את כל ארבעת השלבים, מזהים את החסמים הטכניים שמקשים על מערכות AI לגשת לתוכן שלכם, ומשווים אתכם למתחרים הישירים. תקבלו דוח ראשוני ללא עלות, עם סדר עדיפויות לתיקון. דברו איתנו, או קראו עוד על שירות ה-GEO שלנו.
איך מדדנו?
- המדגם: 22 חברות סייבר B2B שעקבנו אחריהן כמתחרות של לקוח, ובהן הלקוח עצמו. דומיין ראשי אחד לכל חברה.
- הכלי: בדיקת Agent Readiness של Peec AI, שפונה לאתר כמו סוכן ודוגמת את דף הבית, דף מייצג מכל תבנית URL מרכזית וכמה דפים שמקושרים מדף הבית. מודל ארבעת השלבים שלנו מבוסס על שלוש הרמות הראשונות שלה, ומאחד את שתי הרמות העליונות, שעדיין אין להן בדיקות בציון, לשלב אחד.
- המועד: המעקב התחיל באוקטובר 2026. נתוני ההשוואה בין 14 החברות מבוססים על סריקות מ-9 ו-10 בנובמבר 2026. ציר הזמן של Red Button מבוסס על הסריקות האוטומטיות היומיות של הכלי. זו תמונת מצב, ואתרים משתנים.
- מה נספר: חברה נכנסה לניתוח רק אם הבדיקות שלה החזירו תשובה ברורה. 8 חברות שבהן הבדיקה נחסמה או נכשלה מוצגות בנפרד, ולא נספרות ככישלון.
- מגבלות: הבדיקה מגיעה משרתי הכלי ולא מהסורקים עצמם, ולכן חסימה בבדיקה לא מוכיחה חסימה של סוכנים אמיתיים. המחקר מודד מוכנות טכנית, לא ביקורי סורקים, אזכורים או ציטוטים. המדגם קטן ומתחום אחד, ולכן לא מייצג את כל האתרים ברשת.
- שמות: Red Button מוצגת בשמה. המתחרות מוצגות בעילום שם.